
PDF 翻译
PDF 翻译,排版原样保留
上传一份 PDF,选好你要读的语言,拿回来的还是原来那份文件的样子:同样的页、同样的分栏,译文落在原文所在的位置。可以在浏览器里和原文左右对照着读,也可以下载双语版和纯译文版。登录后每月前 300 页免费。
能做什么
还是熟悉的那一页,只是换成了你的语言
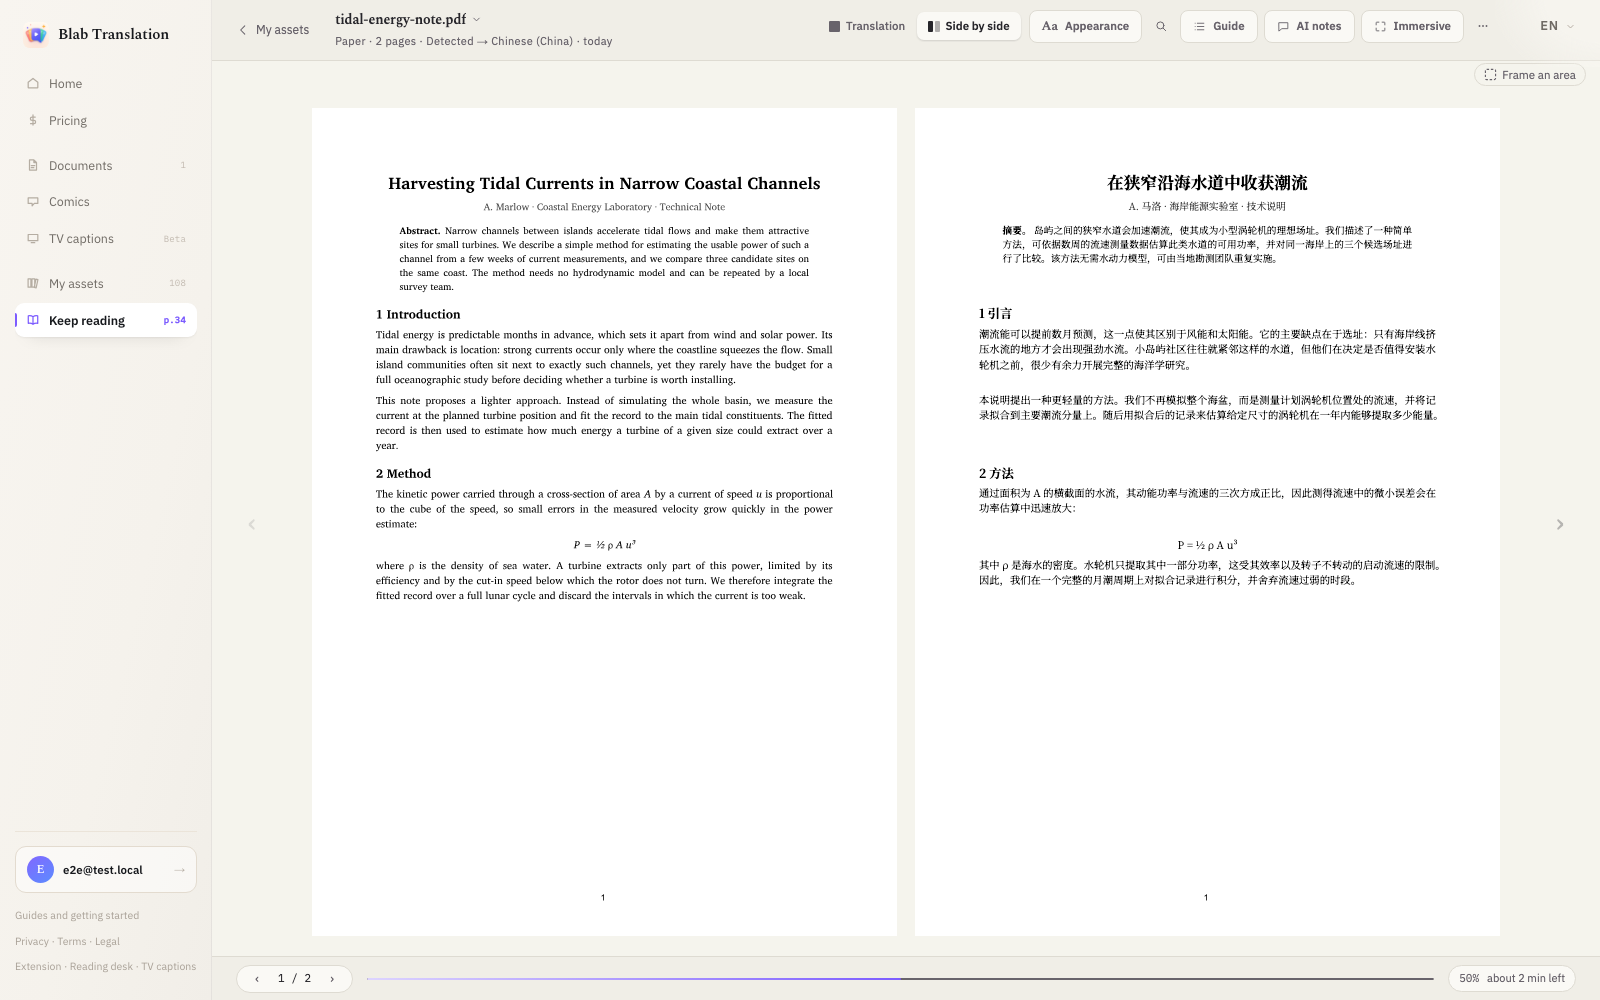
每一页都会按原版重排,译文替换原文落在原处。表格、公式和图注放回原来的位置,图片原封不动,论文读起来仍然像论文。随时可以在“译文”“对照”“原文”三种视图之间切换;整份文档还没译完时,已经完成的页就能先读。
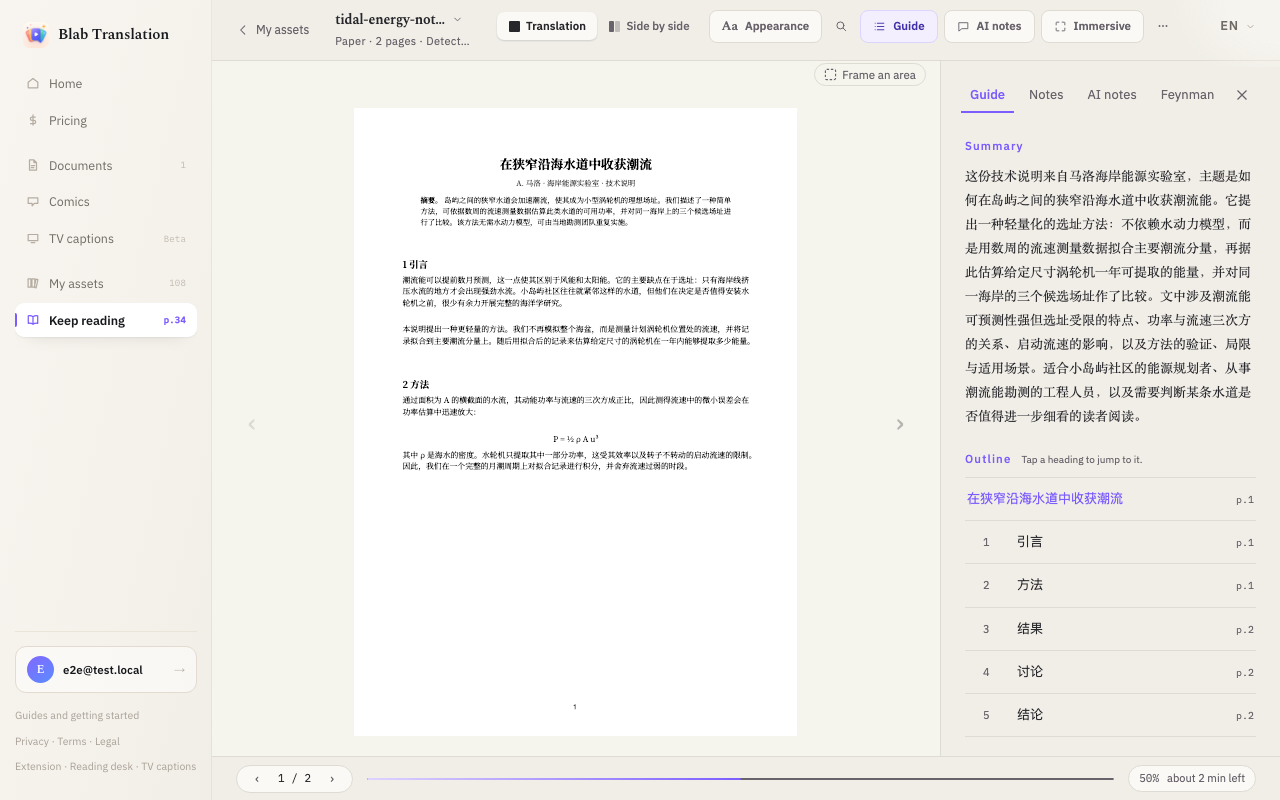
先看导读,再往下读
打开“导读”面板,先看全文摘要和章节大纲,点任意标题就能跳过去。选中一段文字,可以收进术语、让 AI 解释、加高亮、写笔记、修改译文,或者让它重新翻译一遍。
一次导入,双语版和纯译文版都有
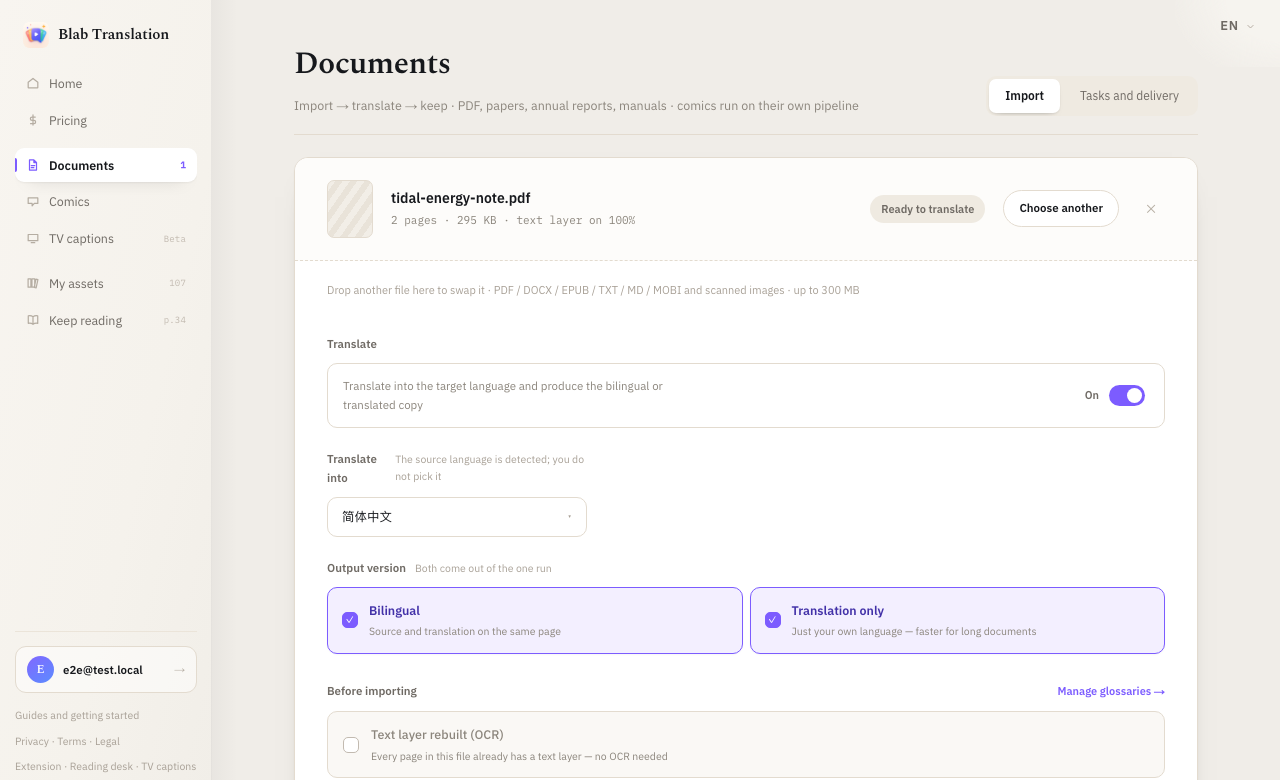
你只需要选目标语言,不用选原文语言。勾上“双语”,一次导入就同时产出两份文件:原文和译文排在同一页的双语版,以及读起来更快的纯译文版;只勾“纯译文”,拿到的就只有译文。导入前还可以套用自己的术语表,让人名和专有名词按你定的译法出来。
扫描件、电子书、文档也能翻
主要由扫描图片组成、读不出文字的 PDF,会整份先用 OCR 识别再翻译;自带文字层的 PDF 直接翻译,不做识别。Word、EPUB、TXT 和 Markdown 也走同一个工作台,译完按原格式交回;MOBI 电子书译好后在阅读台里读,不出文件。笔记能导出成 Markdown,术语表能下载成 CSV 文件。
怎么用
- 01
导入文件
打开“文档”,把 PDF 拖进来,选好要翻译成的语言,再勾选你要的版本。扫描件不用多做什么,会先自动认出来并识别文字。余额不够这次任务时,开始之前就会告诉你。
- 02
边翻边读
前几页译好,文档就会在阅读台打开。用“导读”看摘要和大纲,用“对照”逐句核对原文,用沉浸模式收起侧边面板和导航栏。
- 03
留下需要的东西
下载左右对照的 PDF 或纯译文 PDF,导出笔记。7 天内回来,还是从上次停下的地方接着读,阅读台会记住你的位置。
限制与计费
登录后每月有 300 页 PDF 免费,超出后每页 3 积分。一份 PDF 被认定为扫描件时,它的每一页都另按 OCR 页计费,每页 1 积分;有文字层的 PDF 没有 OCR 费用。向 AI 提问单独计算,每月有 30 次的免费额度,之后每个问题 1 积分 起,问题带上的文档越长,算得越多。不用挑选翻译引擎,也不用准备自己的 API key。
文档在我们的服务器上翻译,而不是在你的浏览器里。上传的原文件和翻译出来的文件会在 7 天后删除。删除之后,这份文档就不能再从我们这里重新翻译了:想再读,需要重新上传;想留着的 PDF,请在那之前下载。
常见问题
翻译后的 PDF 能保留表格和公式吗?
能。表格、公式和图注都会放回原来的位置,图片不做任何改动。每份文档都是这样翻译的,没有开关可以把它关掉。
扫描版 PDF 能翻译吗?
能,而且不用打开任何开关。导入时会抽查开头的几页,如果大多读不出文字,整份文档就按扫描件处理,每一页都用 OCR 识别,按每页 1 积分 收费。识别能读中文、日文和用拉丁字母书写的语言,其他文字的扫描件会被拒绝,并告诉你原因。
需要自己的 AI 密钥吗?
不需要。文档工作台用的是自己的翻译引擎。登录后每月前 300 页不花钱。
文件会保存多久?
原文件和译文会在 7 天后删除。删除之后就没有可以重新翻译的原件了,需要的话请重新上传;想留着的 PDF,请在那之前下载。
能从哪些语言翻译?
原文语言不需要你选,翻译时会从文档本身看出来。你只要选想用哪种语言来读。