
PDF 翻訳
論文翻訳・PDF 翻訳、レイアウトはそのまま
PDF をアップロードして読みたい言語を選ぶだけで、元のファイルと同じ見た目のまま返ってきます。ページも段組みも同じで、訳文は原文があった場所にそのまま収まります。ブラウザで原文と並べて読むことも、対訳版と訳文のみ版をダウンロードすることもできます。ログインすれば、毎月最初の 300 ページは無料です。
できること
いつものページが、あなたの言語で
各ページは原文の代わりに訳文を入れて組み直されます。表、数式、図のキャプションは元の位置に戻り、画像には手を加えません。論文は論文のまま読めます。訳文・対照・原文の三つの表示はいつでも切り替えられ、残りのページを翻訳している間も、できあがったページから読み始められます。
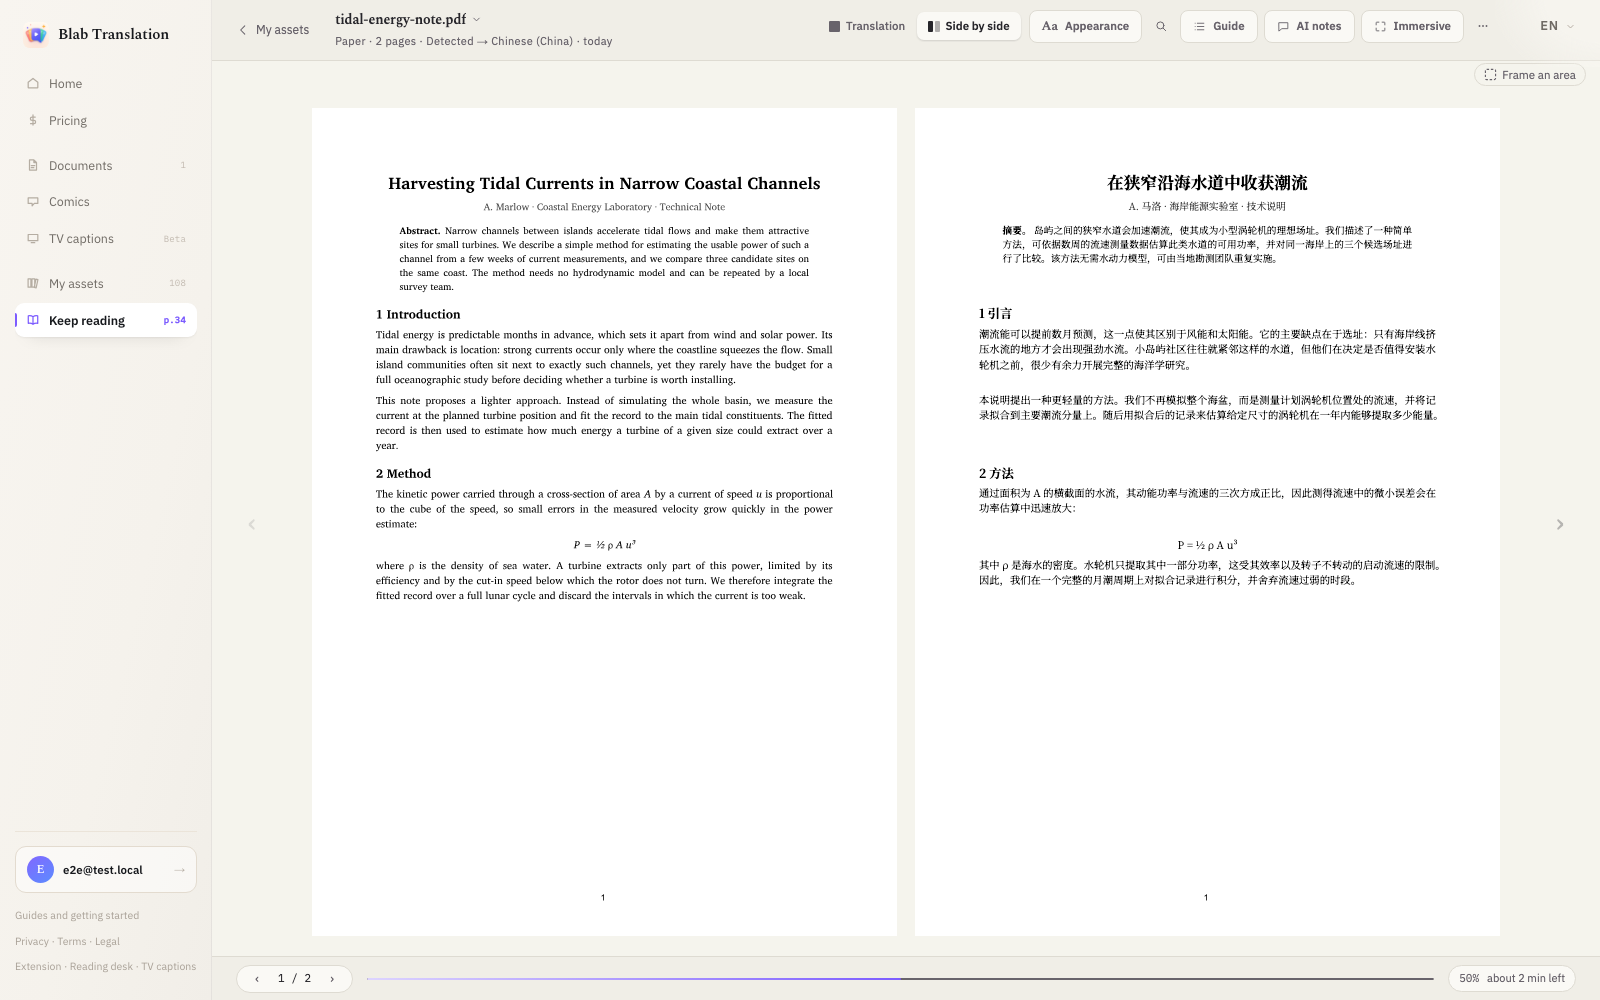
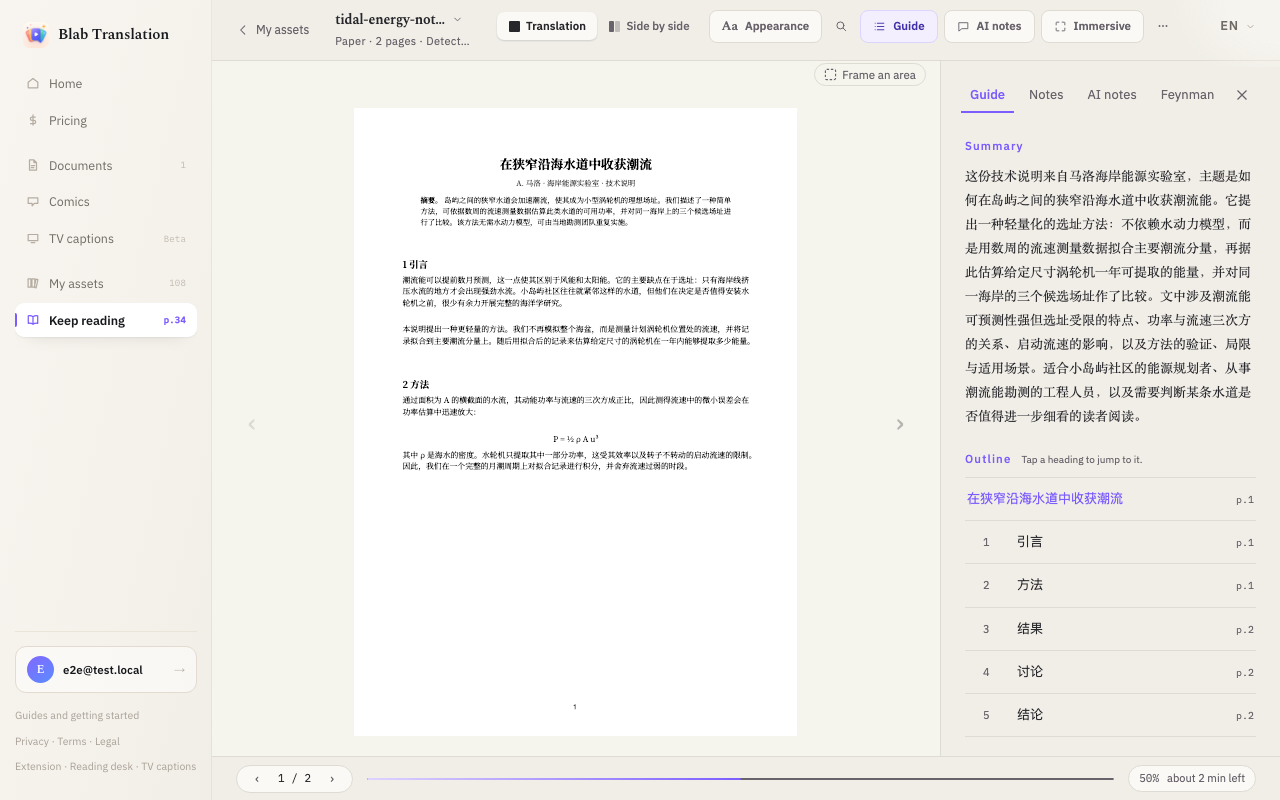
読む前にガイドで全体をつかむ
ガイドパネルを開くと、文書の短い要約と各章の目次が表示され、見出しをタップするとその場所へ移動します。気になる箇所を選択すれば、用語として保存する、AI に解説を頼む、ハイライトする、メモを書く、訳文を修正する、翻訳し直す、といった操作ができます。
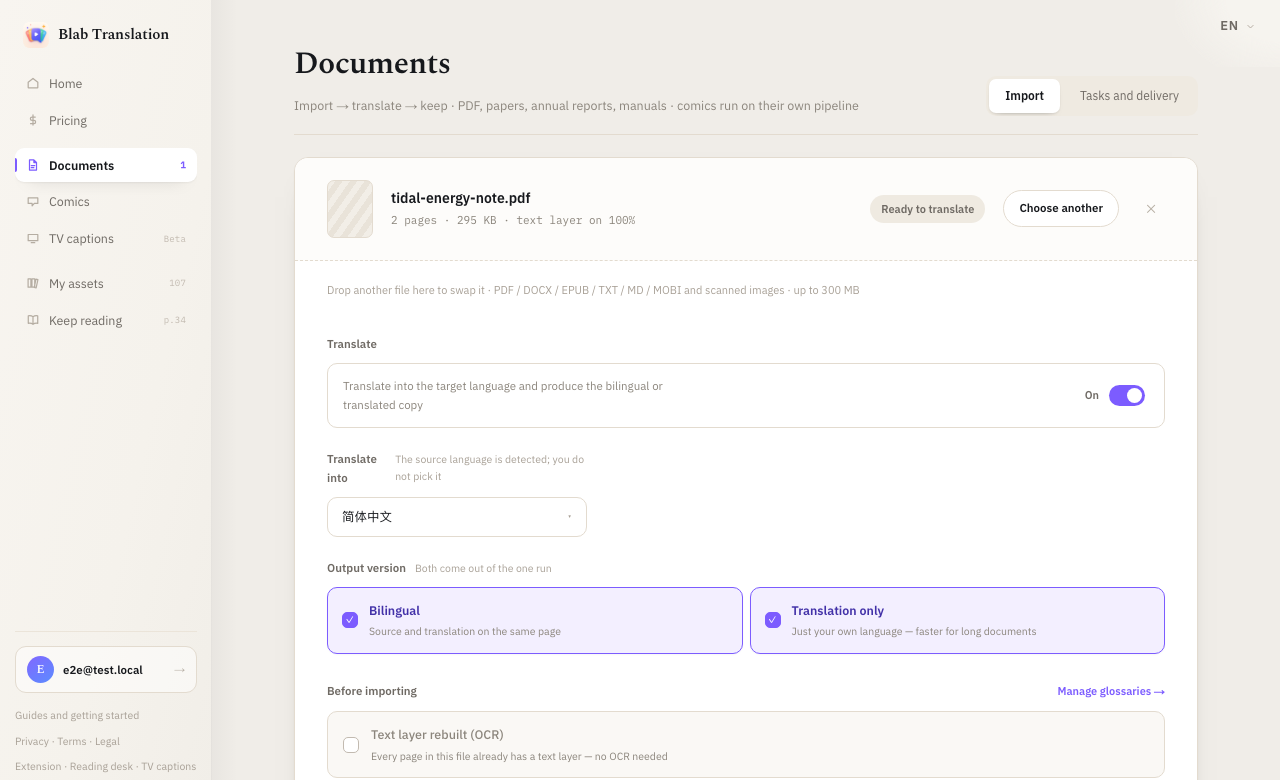
対訳版と訳文のみ版を一度に
選ぶのは翻訳先の言語だけで、原文の言語は選びません。対訳版にチェックを入れれば、一回の取り込みで、原文と訳文を同じページに載せた対訳版と、訳文だけの読みやすい版の両方が作られます。訳文のみ版だけにチェックを入れると、訳文だけが届きます。取り込む前に用語集を一つ適用すれば、人名や専門用語を好きな訳語にそろえられます。
スキャン、電子書籍、文書ファイルも
ほとんどがスキャン画像で文字を読み取れない PDF は、翻訳の前に文書全体を OCR で読み取ります。テキスト層を持つ PDF はそのまま翻訳し、読み取りはしません。Word、EPUB、TXT、Markdown も同じデスクで扱え、訳したあとは元の形式で返ってきます。MOBI の本はリーダーで読むために翻訳され、ファイルは出ません。メモは Markdown で書き出せ、用語集は CSV ファイルとしてダウンロードできます。
使い方
- 01
ファイルを取り込む
ドキュメントを開いて PDF をドラッグし、翻訳先の言語を選びます。必要な版にチェックを入れます。スキャンでも追加の操作は要らず、自動で見分けて先に文字を読み取ります。残高が足りないときは、始める前に知らせます。
- 02
翻訳中から読み始める
最初のページが仕上がった時点で、文書はリーダーで開きます。要約と目次はガイドで、原文との突き合わせは対照表示で。没入モードにすればサイドパネルとナビゲーションが隠れます。
- 03
必要なものを手元に残す
対照 PDF か訳文のみの PDF をダウンロードし、メモを書き出します。7 日以内なら、リーダーが読んでいた位置を覚えているので、続きから読めます。
制限と料金
ログインすると、PDF は毎月 300 ページまで無料です。それを超えると一ページあたり 3 クレジットです。スキャンと判定された PDF は、すべてのページが OCR ページとしても一ページ 1 クレジットで課金されます。テキスト層を持つ PDF に OCR の費用はかかりません。AI への質問には別に毎月 30 回の無料枠があり、その後は一問 1 クレジットからで、長い文書を添えた質問ほど多くかかります。エンジンを選んだり、API キーを用意したりする必要はありません。
文書の翻訳はブラウザではなく、当社のサーバーで行います。アップロードしたファイルと翻訳済みのファイルは 7 日後に削除されます。削除後は、当社の控えからその文書を翻訳し直すことはできません。もう一度読むにはファイルをアップロードし直してください。残したい PDF は、それまでにダウンロードしておいてください。
よくある質問
翻訳した PDF でも表や数式は崩れませんか?
崩れません。表、数式、図のキャプションは元の位置に戻り、画像には手を加えません。これはすべての文書に適用される処理で、オフにする設定はありません。
スキャンした PDF も翻訳できますか?
できます。何かをオンにする必要もありません。取り込み時に最初の数ページを調べ、文字を持つページが少なければ文書全体をスキャンとして扱い、すべてのページを OCR で読み取ります。一ページ 1 クレジットです。読み取れるのは中国語、日本語、ラテン文字で書かれた言語で、ほかの文字のスキャンは理由を添えてお断りします。
自分の AI キーは必要ですか?
必要ありません。ドキュメントのデスクは専用の翻訳エンジンを使います。ログインすれば、毎月最初の 300 ページは無料です。
ファイルはいつまで保存されますか?
原文ファイルと訳文ファイルは 7 日後に削除されます。削除後は翻訳し直せるものが残らないので、必要ならファイルをアップロードし直してください。残したい PDF は、それまでにダウンロードしておいてください。
PDF ファイルを日本語に翻訳するには?
PDF ファイルをアップロードして、翻訳先に日本語を選ぶだけです。原文の言語を指定する必要はなく、翻訳の際に文書そのものから読み取ります。ログインすれば、毎月最初の 300 ページは無料で翻訳できます。